百度ERNIE Evolve自动做研究,多项指标达SOTA
参考文章 · 原文来源:胜算云精益社区
图片来源:Hacker News · AI
11月9日,百度文心首次披露自动研究系统ERNIE Evolve。据量子位报道,该系统能自主提出研究方向、开展实验、验证结果并积累经验,已投入文心5.5 Flash研发,多项指标达到公开SOTA。Hacker News当晚收录了百度技术博客页面。
外层找方向,内层跑实验
量子位称,ERNIE Evolve属于RSI(Recursive Self-Improvement,递归自我改进)路线,让AI参与自身研发流程、形成自我改进闭环,OpenAI、Anthropic、腾讯、智谱等厂商也在探索。在NanoChat AutoResearch和NanoGPT Speedrun两项任务的三个评测指标上,它均取得目前公开验证的SOTA表现。
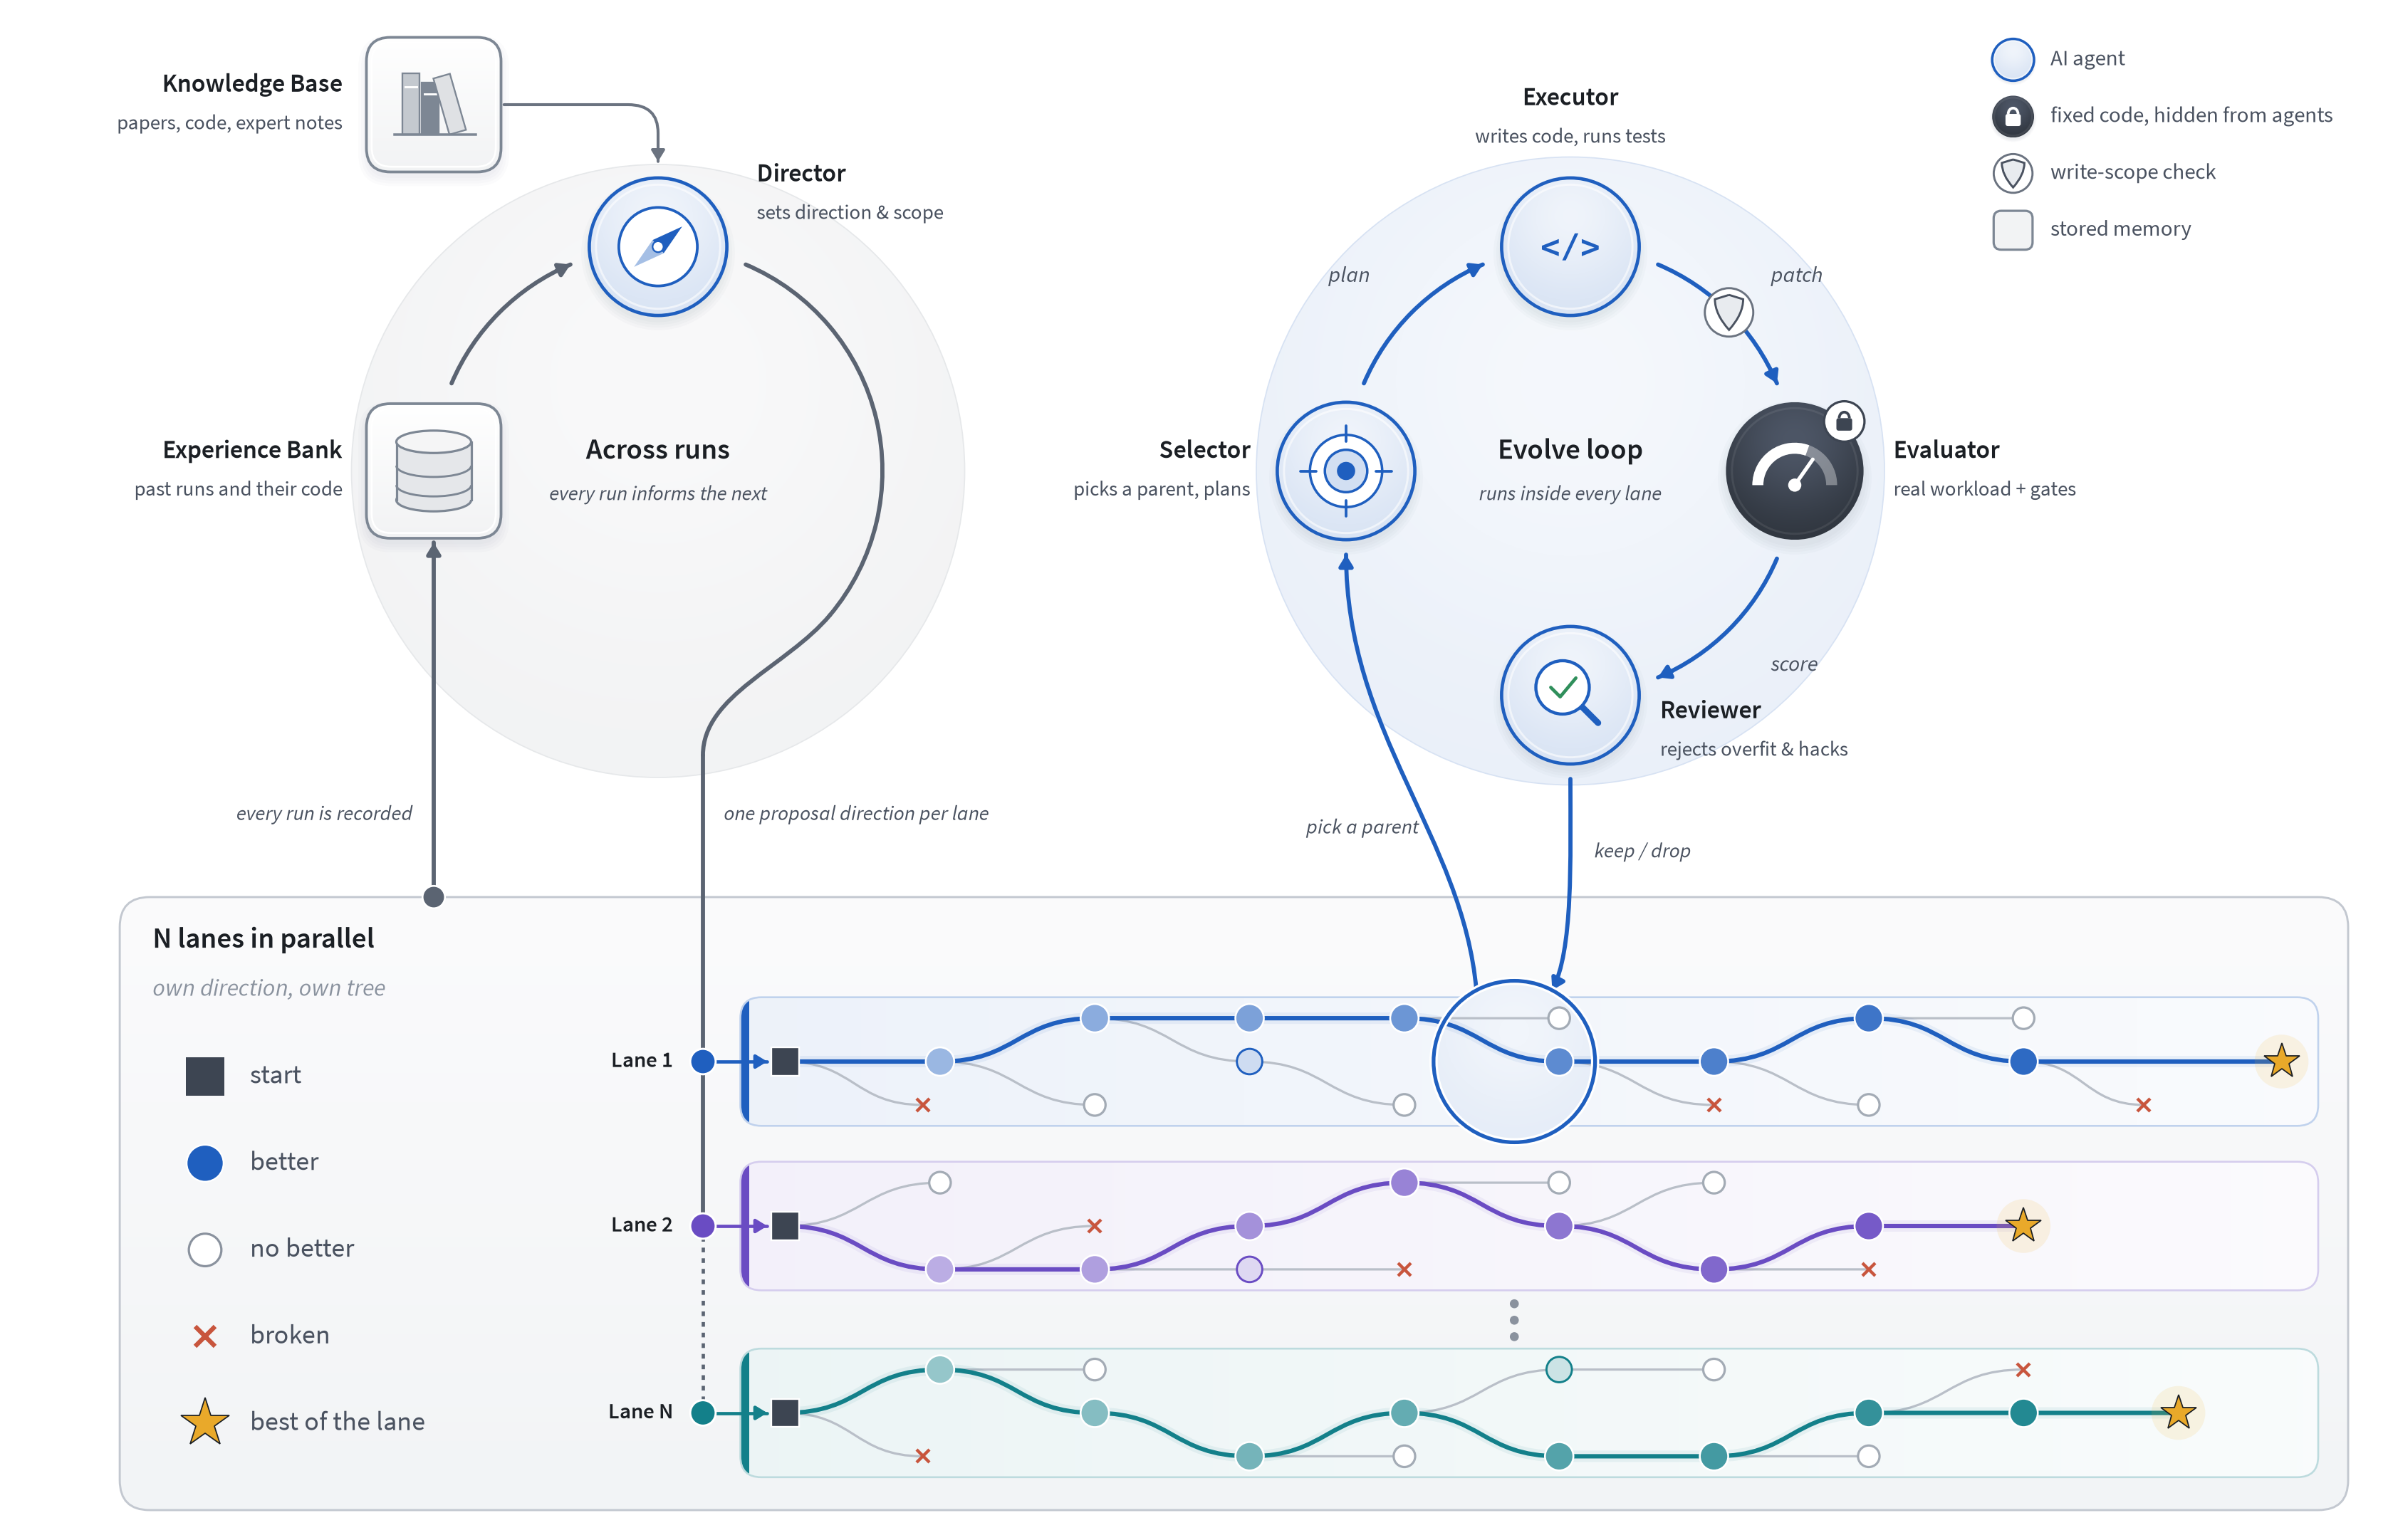
系统用双层循环组织研究:外层结合历史实验结果提出新方向、并行探索多条研究线;内层对具体方向持续修改代码、评测效果、沉淀经验。Director选择研究方向,Selector确定每轮实验的目标和代码起点,Executor修改代码生成新版本,Evaluator评测性能,Reviewer检查是否偏离目标、有无评测漏洞——只有通过评测和复核的改进才能保留。
图片来源:Hacker News · AI
生成速度提到基线的623.6%
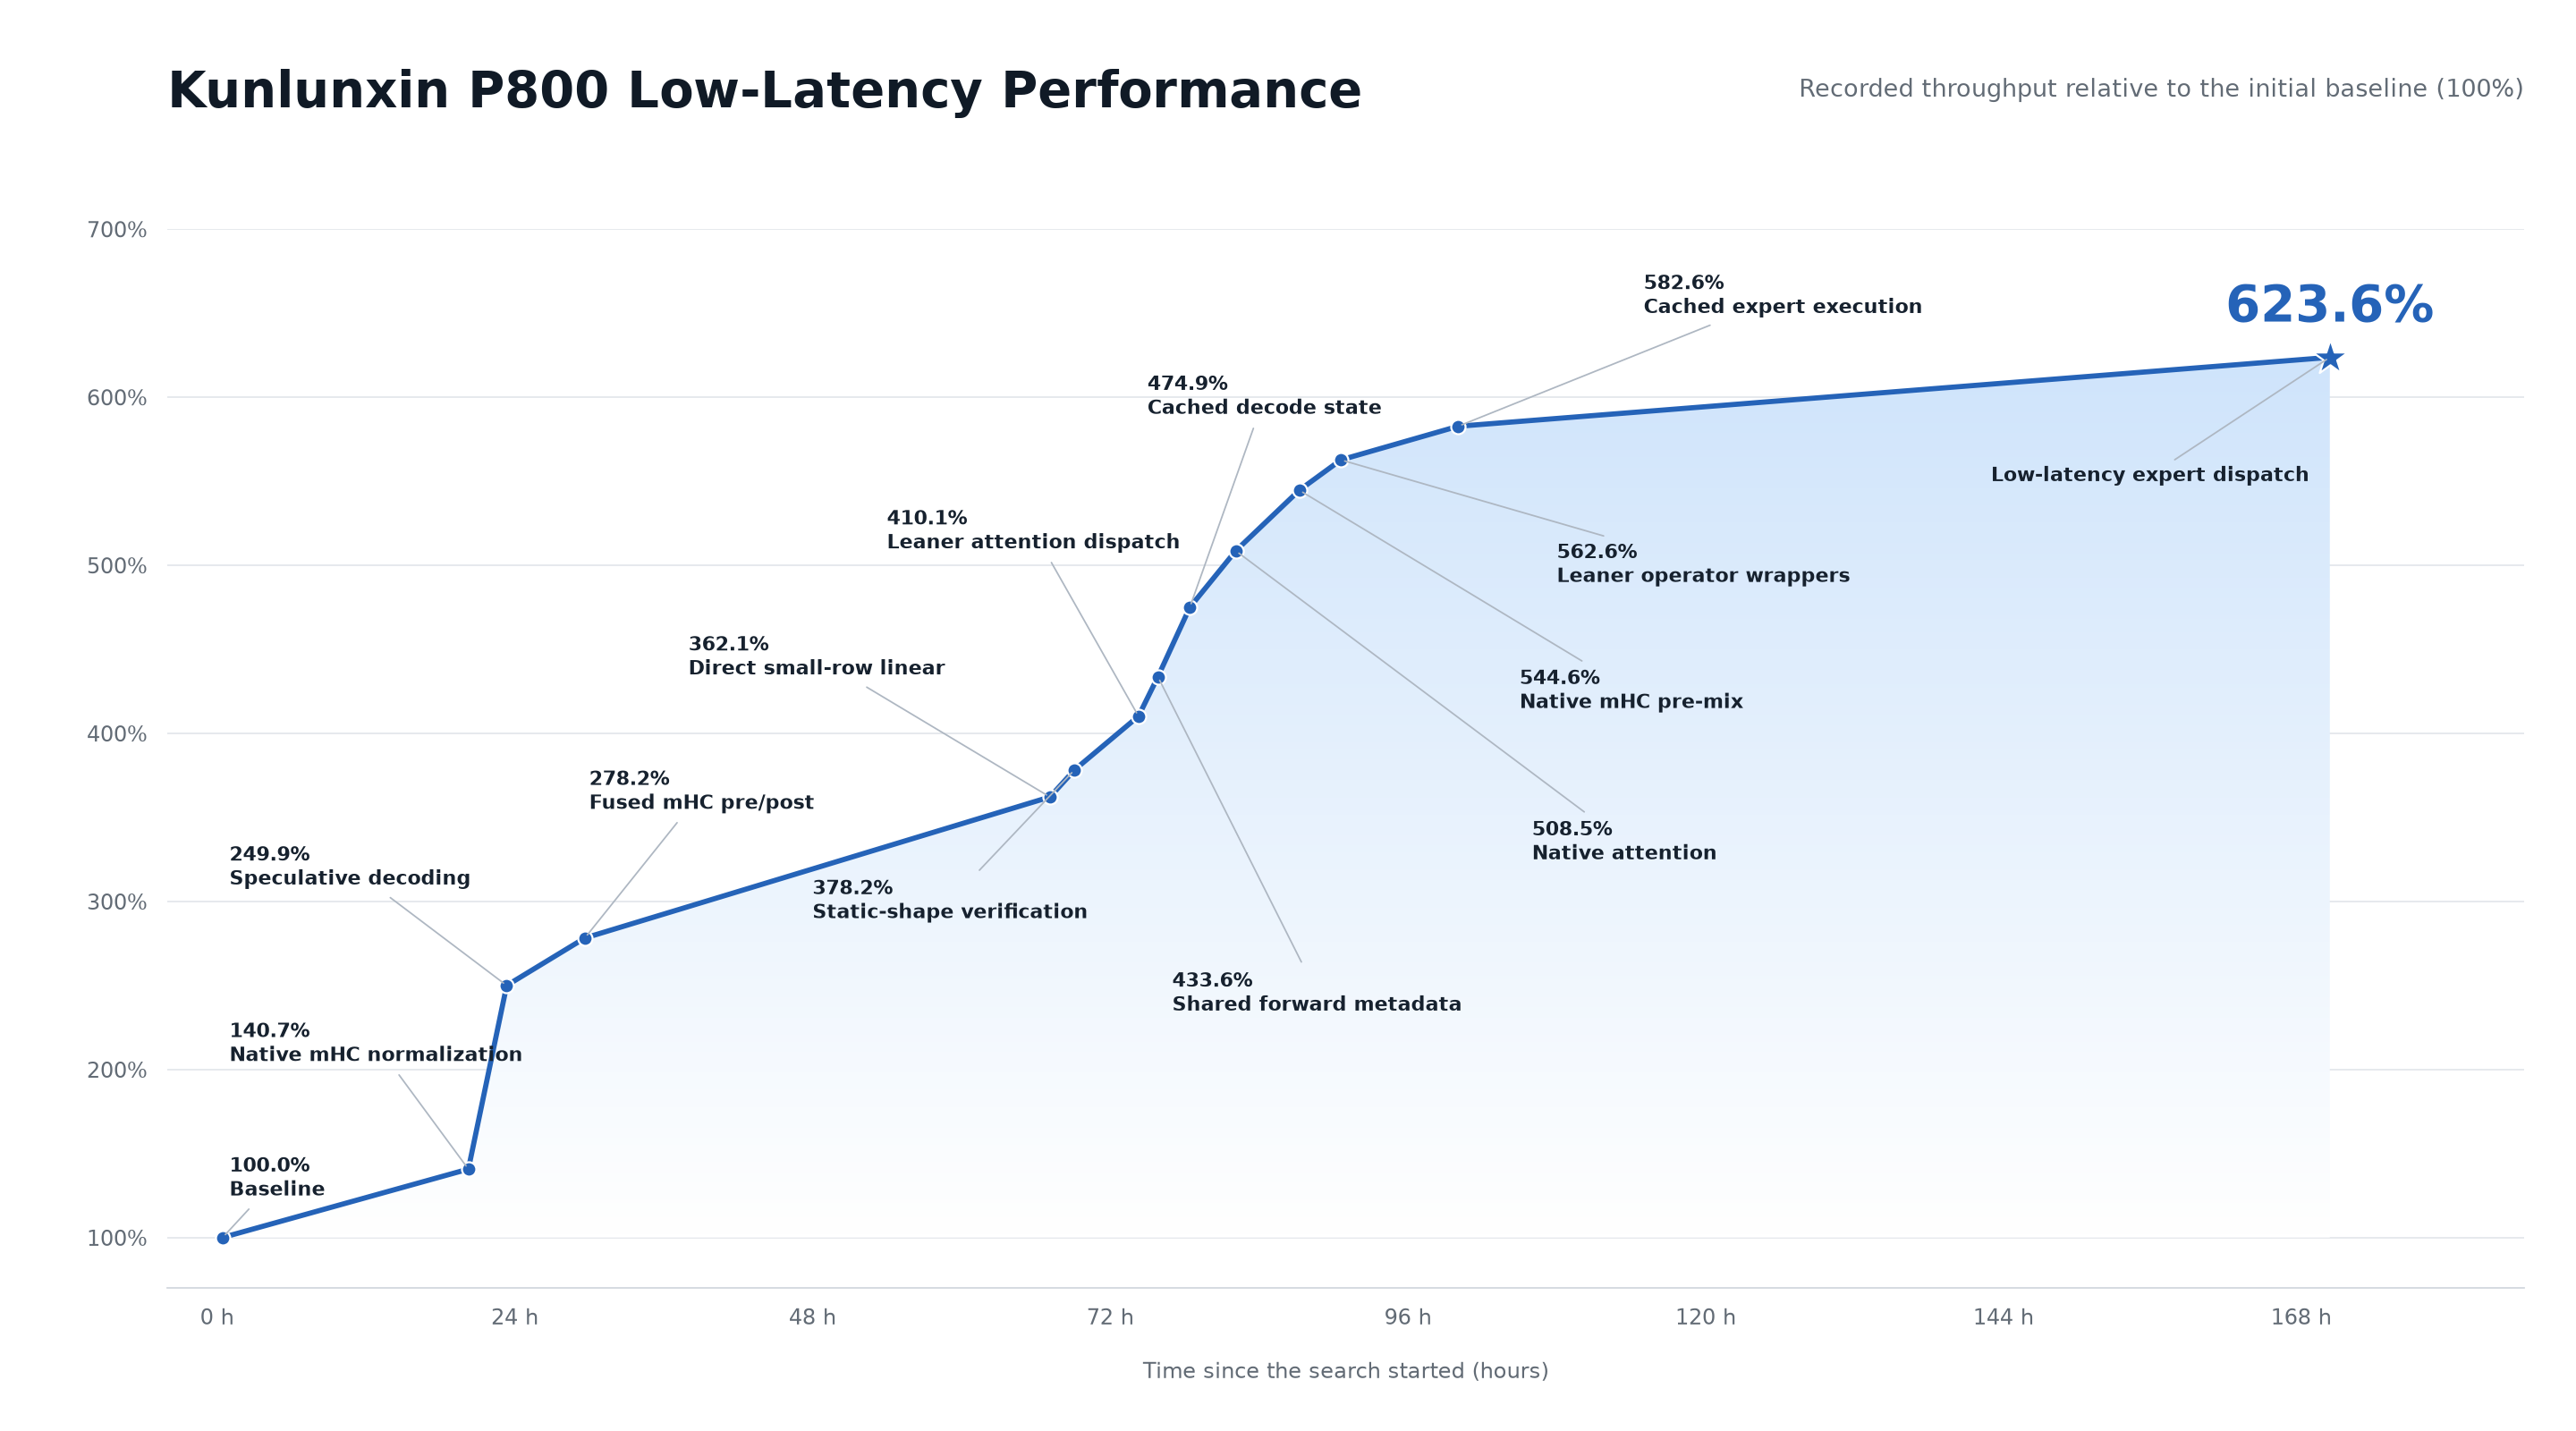
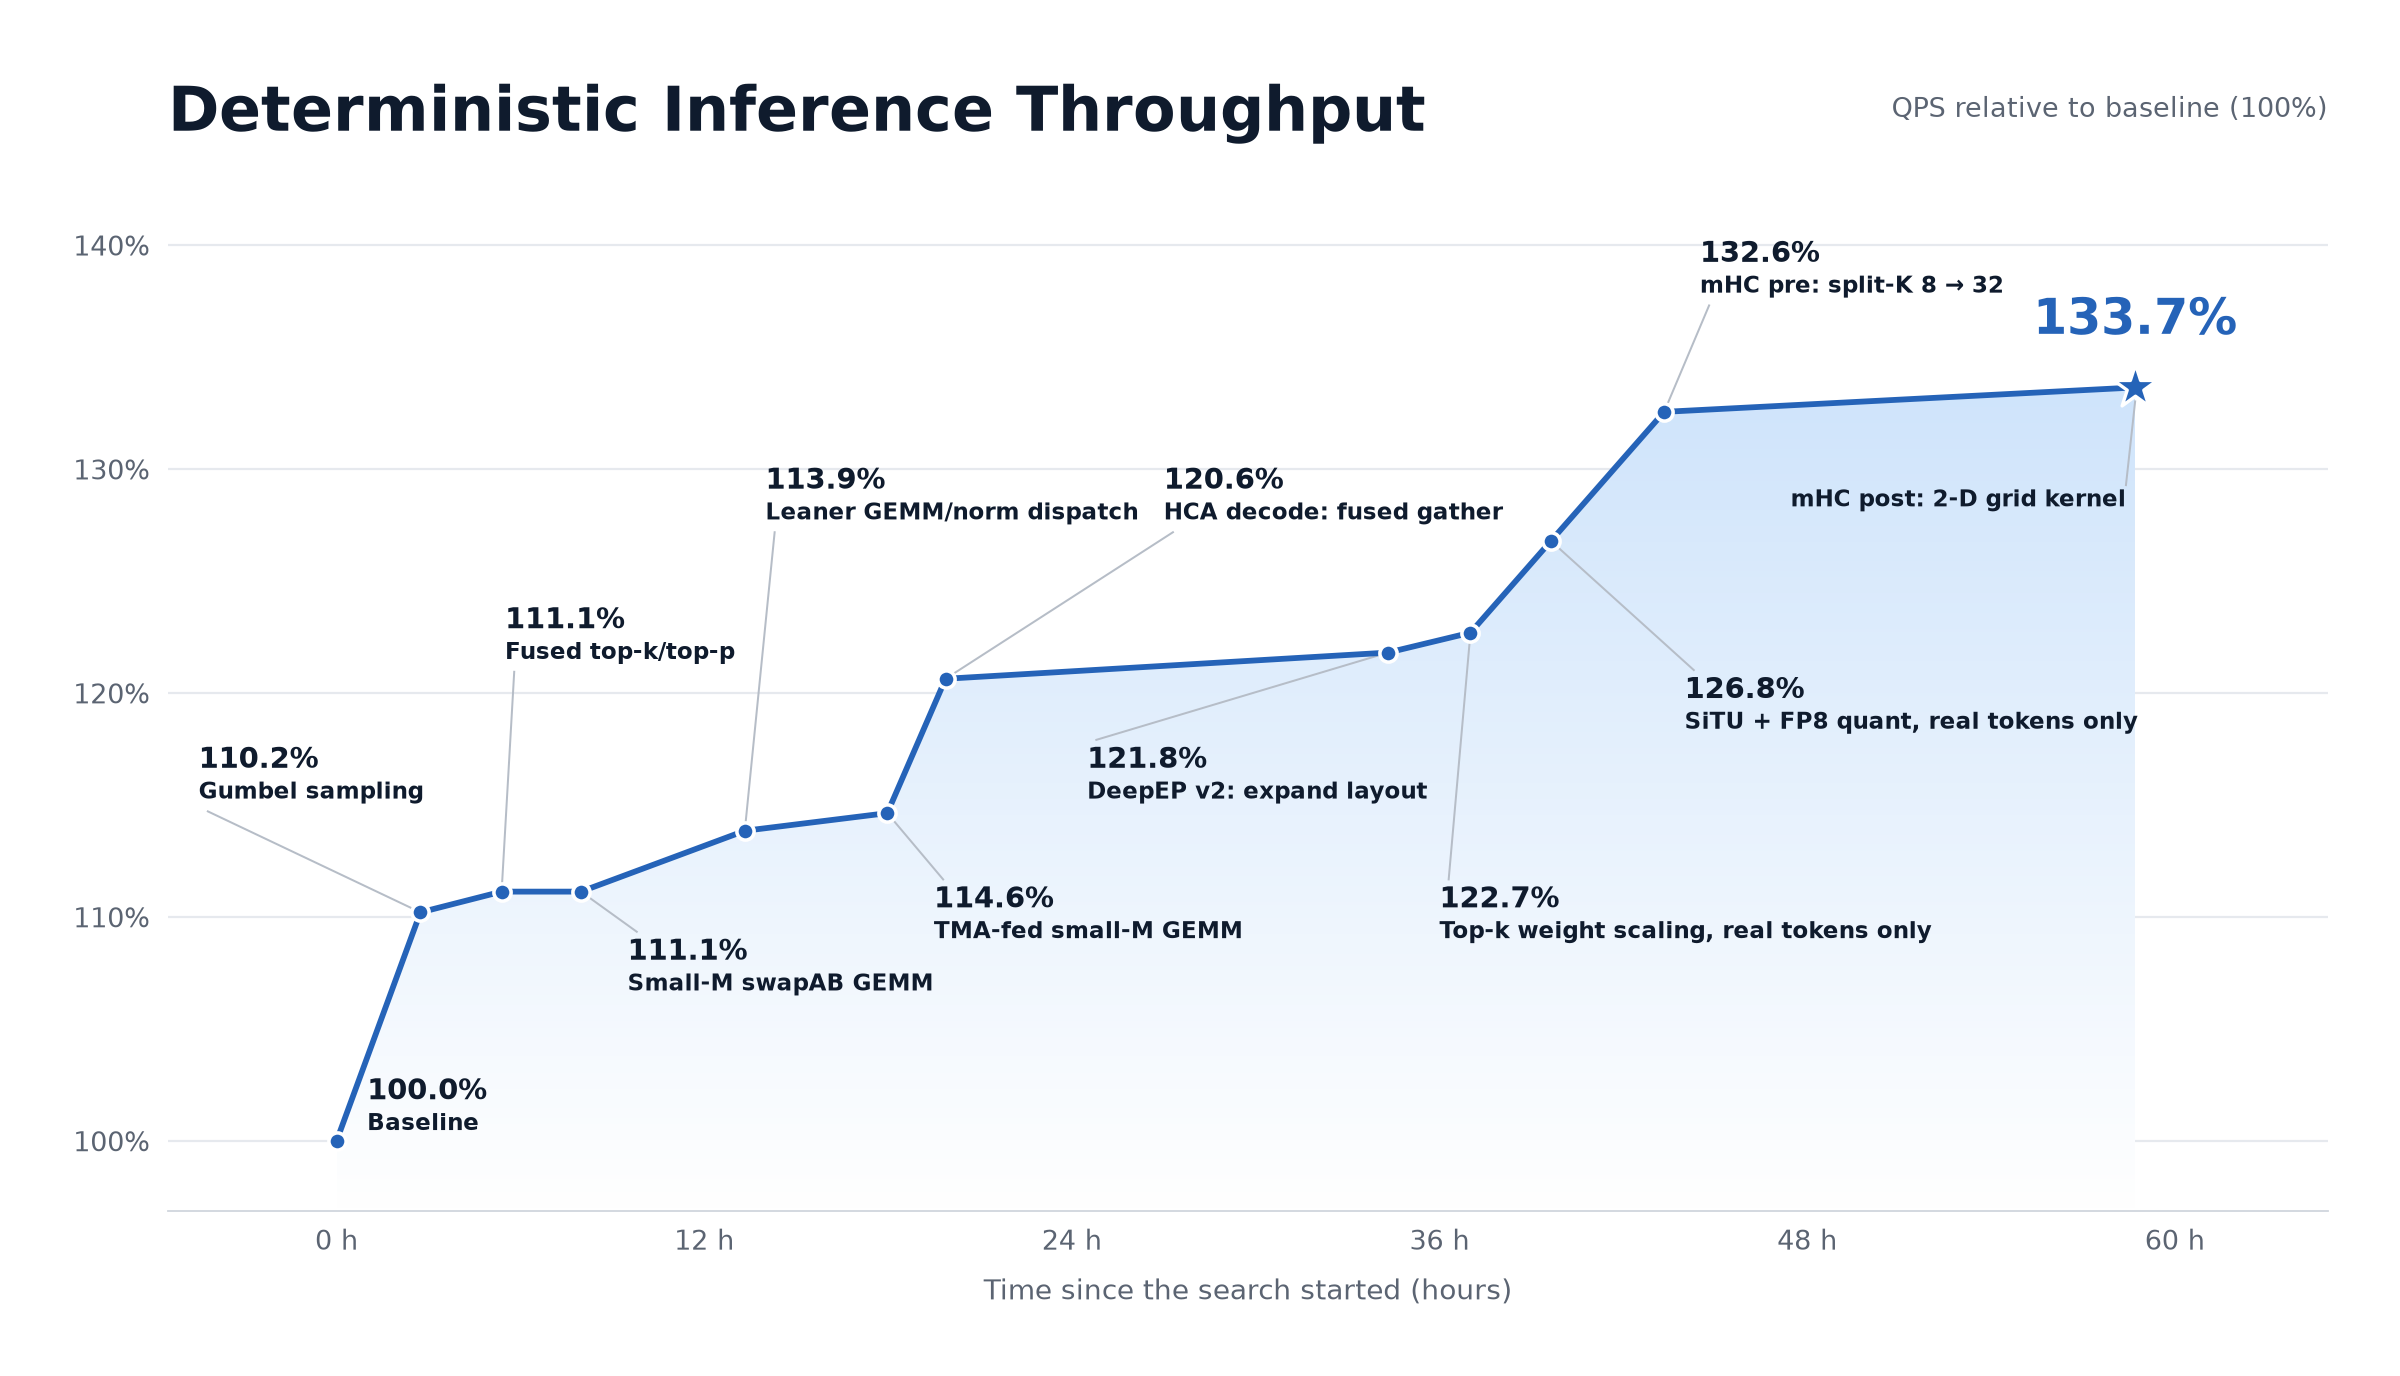
接入真实研发后,收益写在数字里。据量子位报道,昆仑芯P800低时延场景优化中,ERNIE Evolve历时约168小时、4轮方向探索,接入原生融合算子、启用投机解码,再优化主机调度与通信路径,最优版本生成速度提升至基线的623.6%。确定性推理吞吐优化中,它用3天探索3个方向,在严格保持确定性的前提下,吞吐提升至基线的133.7%,平均每token生成时间缩短26%,首token延迟降低12%。极致解码速度优化中,系统累计探索7个研究方向,其中3个有效:MoE与mHC算子、矩阵乘与调度策略、草稿模型关键路径,推理性能累计提升至基线的114.9%,精度与基线保持一致。上述改动均通过文心团队压测与正确性检查,完成生产级验证。
图片来源:Hacker News · AI
前情:2800亿参数基座已开源
11月5日,百度先一步开源文心5.5 Flash Base。据量子位报道,模型采用MoE架构,总参数量2800亿,每个token激活140亿参数,用33.5万亿token完成预训练,预训练上下文最高128K,在知识、推理、数学、代码、多语言和长上下文等基准上刷新同尺寸SOTA,超过DeepSeek-V4-Flash-Base等模型。
架构上,Latent-Gated Sparse Attention把门控投影权重参数减少75%;ECHO复用主干最后一层学习预测后续token,省去MTP模块,还能充当投机解码的草稿模型。权重已上线HuggingFace。接近百度的人士透露,文心新模型或将于近期发布。
第一个落点,和落点之外的边界
推理基础设施优化是RSI在真实研发中的第一个落点。——文心技术博客
博客同时称,同样的研究闭环将逐步延伸至训练系统优化、模型能力研究和评测体系迭代;扩展将在明确的目标、权限和资源边界内进行,并接受持续的安全评估与人工监督。
机器写代码、跑评测、积累经验;人给出目标、划出边界、守住复核。研究方向可以交给系统,「为什么研究」仍由人回答。当AI学会做研究,人的位置从答题者移向出题者。